Kingdee Cloud Galaxy BI Data Foundation
Why the Data Foundation Deserves Its Own Spotlight The costliest issue to troubleshoot is when results remain invisible. This end-to-end solution spans four layers: data ingestion, governance and consolidation, a metrics hub, and application visualization. Understanding this layered architecture reveals how the approach delivers a same-day closed loop for "data querying." Most BI evaluations focus on the top two layers—dashboard aesthetics and query accuracy. These are the most demo-friendly and prone to misjudgment regarding complexity. The real determinants of success lie in the bottom two layers: how data is ingested and how multi-ledger datasets are consolidated. Without a solid foundation here, even the most polished upper layers are built on unstable ground that can collapse at any moment. This article focuses exclusively on these foundational layers. Though less visible, every detail addresses specific enterprise scenarios and real-world pitfalls.
一、数据接入:把云星空的数据完整、准时搬出来
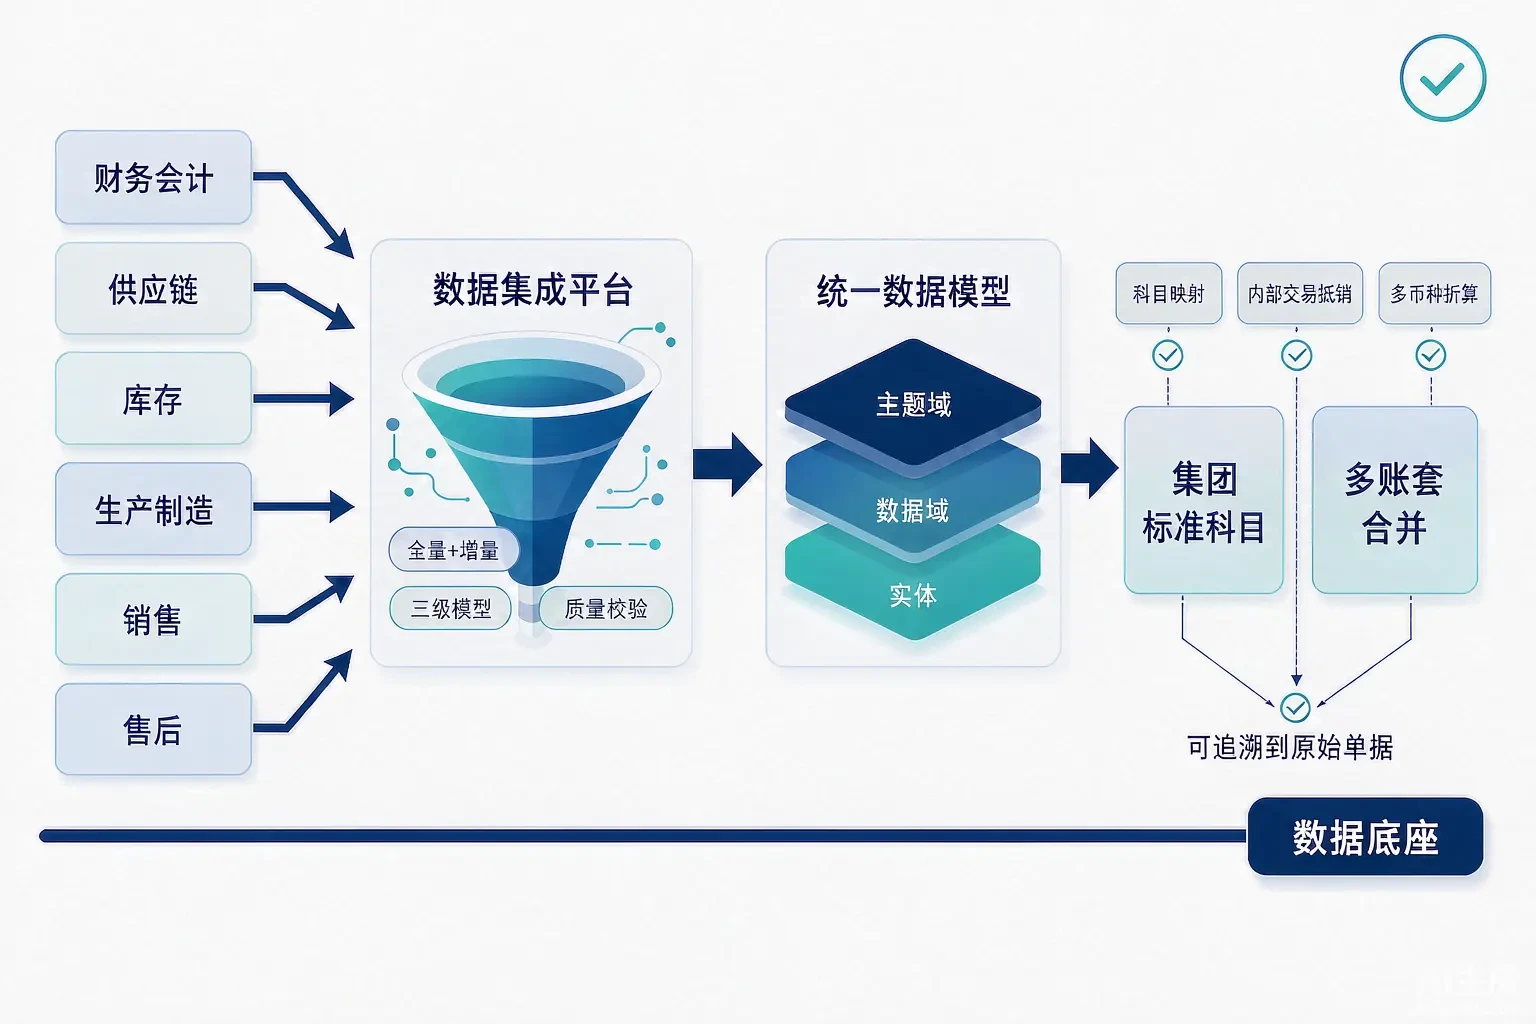
云星空的数据分布在财务会计、供应链、库存、生产制造、销售、售后等多个业务域,标准方案通过数据集成平台按业务域建模抽取。
核心是三件事。
1. 全量加增量结合
主数据与组织架构走全量同步,业务单据按更新时间戳增量抽取。
为什么要分开处理?因为两类数据的性质完全不同。
主数据(组织架构、物料、客户、供应商、科目等)变化频率低,但每一次变化都会影响大量历史单据的解释——比如某个物料改了名称,历史单据显示的名字也变了。所以主数据必须全量同步,且要保留变更历史,否则会出现"老单据上的组织名和现在不一样"的诡异现象。
业务单据(凭证、订单、库存单、工单等)数据量大、变化频繁。全量跑批的问题不只是慢——它会在业务高峰期占用生产库资源,影响正常开单和过账。很多企业的第一次数据抽取就因为"跑得太重"被业务部门叫停,项目从此搁浅。
按更新时间戳做增量,既保证时效,又把对生产库的压力控制在一个可接受的区间。
一个容易忽略的细节:增量的"水位"要能自愈。如果某次同步中断,增量逻辑必须能自动追平,而不是永远从断点往后跑。少了这个机制,数据底座会在某次网络抖动后悄悄缺一段数据,而报表上完全看不出来。
2. 统一落库规范
按"主题域—数据域—实体"三级组织模型落库,财务凭证、销售订单、生产工单各自成域,但共享统一的组织、往来单位、物料、客户等公共维度。
这套三级结构的作用是让不同业务域的数据可以互相拼接,同时保持各自的业务语义。
举个实际的例子:财务凭证和销售订单是两个业务域,凭证里记的是借方科目、金额、币种,订单里记的是产品、数量、单价、交付日期——两者字段完全不同。但当你要回答"华东区某客户的回款周期为什么变长"时,需要把销售订单、客户档案、收款凭证、账龄表串起来看。
只有当这几个域共享了组织、往来单位、物料、客户这几个公共维度,且这些维度的编码在所有域里是同一套,串联才成立。
这里的关键是"同一套"三个字。如果财务域用客户编码 A、销售域用客户编码 B,哪怕名称看起来一样,跨域关联就无从谈起——这往往是企业自建报表时最耗时的部分:手工做主数据对照表。
三级模型的另一层价值是扩展性。当企业新增一条产品线、或者上一个新模块(比如云星空的某个新业务域),按同一套规范接入即可,不需要重构整个模型。
3. 数据质量校验
同步完成后自动做行数比对、金额勾稽、关键字段空值检查,异常自动告警。
这一条最容易被当成"附加功能",实际上它是数据底座里最省钱的一块。
行数比对回答的是"数据有没有少":本期抽取的行数与上一期、与源端的预估量级是否吻合,掉了 30% 就告警。
金额勾稽回答的是"数据有没有错":借贷是否平衡、合计是否等于各分项之和、期初加本期发生是否等于期末。这一条能拦下大量"报表没数"和"数对不上"。
关键字段空值检查回答的是"数据能不能用":科目为空、组织为空、单据日期为空——这些数据即使同步成功,也会在后续关联时把结果带偏。
为什么说它最省钱?因为排查一个"数对不上"的问题,代价可能是几天的数据比对和口径回溯;而自动校验在同步完成的瞬间就把问题暴露了。
一个务实的建议:这三条校验规则不必一次配齐,可以先配行数比对和金额勾稽——这两条拦住的问题占比最高。剩下的一条条加。
关键决策
错误做法
正确做法
代价
抽取策略
全量跑批接业务单据
主数据全量 + 单据增量
生产库被压垮,项目被叫停
维度编码
各业务域各自编码
全域共享同一套公共维度
跨域无法关联,手工对照表
增量断点
从断点往后跑
水位自愈,自动追平
悄悄缺数据,报表上看不出
质量校验
先上线,后补校验
同步完成即校验并告警
排查成本以天计
科目映射
一对一简单映射
支持多对多,保留空行位
下期有发生额时合并断裂
内部抵销
只看往来单位匹配
往来单位 + 物料 + 期间三维匹配
跨期交易差额沉淀到异常科目
折算规则
写在某个 Excel 里
固化在指标层
同一笔业务在不同报表折出两个数
合并结果
输出一张独立结果表
作为模型处理逻辑落回统一模型
合并表钻不到明细,血缘断裂
二、多账套合并:集团企业的第一道坎
多组织、多账套、多币种企业做云星空多账套合并,难点不在技术实现,而在三条规则必须提前定死。
规则一:科目与组织映射
不同账套的科目体系、辅助核算维度不一致,需要建立统一映射表,把各账套科目归集到集团标准科目,否则合并口径永远对不齐。
现实中的科目体系差异往往比想象中大。集团 A 账套把"销售费用"拆成"运费""佣金""推广费"三个二级科目,B 账套只设一个"销售费用"再靠辅助核算维度区分;C 账套则把运费直接计入"主营业务成本"。同一个业务,在三个账套里落在完全不同的科目上。
映射表要解决的就是这件事:把 B 的"销售费用"拆开映射到 A 的三个科目,C 的运费映射到 A 的运费科目。映射关系是多对多的,不是简单的一对一——这决定了映射表本身的维护成本,也决定了它必须由财务确认而不是由技术定。
映射表还要处理辅助核算维度的差异。A 账套按"部门 + 费用类型"两个辅助核算,B 账套只按"部门"。合并时要么统一维度,要么在映射时固定某一侧的取值规则——这必须写清楚,否则合并出来的费用结构在集团层面是错的。
还有一个必答的问题:账套没有的科目怎么办?某账套本期没有发生额,不代表它在标准科目体系里不存在。映射表里要保留空行位,否则下个季度一旦发生,合并就断了。
规则二:内部交易抵销
集团内关联交易必须互抵,否则合并收入虚增。方案支持按往来单位、物料、期间做内部交易识别与抵销,抵销过程可追溯到每一笔原始单据。
这一条是合并的技术核心,也是最容易被做错的地方。
识别内部交易的基础是:交易双方都在集团范围内。所以集团组织范围清单本身就是合并规则的一部分——哪些组织算内部、哪些算外部,是一条需要明确声明的规则,而不是默认行为。
在此基础上做匹配。常见的匹配维度有三个:往来单位(同一个客户既买又卖)、物料(同一物料在集团内流转)、期间(同一笔交易在两个账套的确认时间是否一致)。三者组合起来,识别的准确性才够。
期间差异是最容易漏的一环。A 账套在 12 月确认了销售,B 账套在次年 1 月确认采购——这笔内部交易在 12 月的合并里对不上,差额会跑到"少数股东权益"或"未确认内部交易"科目上。成熟的方案会按规则做跨期匹配与暂估抵销,而不是让差额自然沉淀。
可追溯到每一笔原始单据,这五个字是这一规则的验收标准。具体来说,要能回答:合并报表里的这行抵销金额,由哪几笔内部交易构成?匹配依据是哪个维度?匹配时点差异怎么处理的?
不能回答,就说明抵销是黑盒。而抵销恰恰是合并报表中最容易被审计和财务追问的部分。
规则三:多币种与折算
外币账套按即期汇率或期末汇率折算,汇率来源与折算方式需在指标层明示,避免出现"合并数没人敢认"的局面。
这一条的关键是规则要写在指标层,而不是藏在某个 Excel 的单元格里。
两个关键决策点:
用即期汇率还是期末汇率。即期汇率是交易发生时的汇率,更贴近业务实质;期末汇率是资产负债表日汇率,反映折算后的账面价值。集团合并报表的惯例通常是:损益类项目用即期汇率(或期间平均汇率),资产负债表项目用期末汇率。选哪一种必须明确写下来,因为两种方法出来的利润数不同。
汇率从哪来。财务部门维护的月度汇率表?还是财务系统里的自动折算结果?如果两个来源并存而没有指定优先级,同一笔外币业务在不同报表里会折出两个数。
为什么必须放在指标层:指标层是所有报表的共同来源。折算规则写在指标层,意味着看板、报表、财务分析、AI 问数里的人民币金额都是同一个折算口径;写在某个 Excel 里,则意味着只有那一张表是对的。
合并完成后,集团层与各事业部层的数据可以同屏呈现:既看得到集团整体毛利,也能一键下钻到某个账套、某个工厂的明细。
合并层最贵的返工
合并规则写在合并工具里、输出一张孤立的结果表,是这类项目中最常见也最贵的返工点——因为它把"合并"做成了一个终点,而不是数据链路中的一个处理环节。等到管理层问出"这个数怎么来的",血缘已经断了,返工的不是一张表,而是整条链路。
三、两层是怎么衔接的
数据接入与多账套合并不是两件独立的事,它们之间有一个关键衔接点:映射与抵销的结果,必须落回统一数据模型,才能被指标层复用。
常见的失败是这样:接入层把数据搬进来了,模型建得也不错;但合并规则写在合并工具里,输出的是一张独立的合并报表。这张报表和明细数据之间没有血缘关系——合并表里的一个数字,钻不到明细;明细加起来也不等于合并表。
正确的做法是:抵销与折算作为数据模型中的一种处理逻辑存在,而不是一张孤立的结果表。这样合并后的数据仍然是"可下钻"的数据:集团毛利能一路点到账套、点到单据、点到那笔被抵销掉的内部交易。
这一点决定了合并之后的经营分析是"活的"还是"死的"。合并报表如果只是一张静态的表,管理层看完集团毛利就结束了,问不出"哪个账套贡献了""抵销了多少""折算影响多少"。
四、底座是否扎实的六个信号
给一个自查清单。如果下面这些描述符合你的现状,说明数据底座还需要补:
● 信号一:每次出报表都要人工导数据、贴 Excel、重新合并一遍。
● 信号二:财务说合并数和系统里的数对不上,但没人说得清差在哪。
● 信号三:集团合并报表只有一个月度快照,做不了期间对比。
● 信号四:外币账套的数据单独看没问题,一合并就对不上。
● 信号五:想知道"华东区贡献了多少毛利",需要财务单独出一版数。
● 信号六:业务部门抱怨"数据部取数把系统搞慢了"。
反过来说,底座扎实的表现是:任何一个集团层面的数字,都能一路点到原始单据;任何一次口径调整,都只改一个地方。
五、常见问题快答
多账套合并要多久?取决于账套数量与差异程度。单集团、三个以内账套,映射规则梳理通常 1 至 2 周;如果是并购形成的多币种多账套,梳理周期会明显拉长。经验上,映射表的质量比数量更影响进度——三张认真做过的映射表,比二十张挂着的强。
合并会不会影响生产库性能?走标准集成平台、通过抽取通道取数,对生产库的压力远小于直连查询。关键在于抽取策略要区分主数据与业务单据,按增量节奏走。
数据同步是实时的吗?可以做到接近实时——业务单据类数据支持分钟级增量抽取。但结账类数据建议按结账节奏同步。为了"实时"去频繁扫生产库,是把分析需求转嫁给业务系统,得不偿失。
账套中途增加或合并怎么办?统一模型与标准科目体系的存在就是为了这件事。新增账套按映射表接入即可,不需要重构上层指标与报表——前提是映射规则从一开始就设计成可扩展的。
不同账套的辅助核算维度不一样怎么办?需要在映射表中明确固定规则:统一到哪一侧、以哪一侧为准、差异部分归入哪个维度。这个决策必须由财务拍板,技术无法替代。
合并口径改了,以前的数要不要重算?要。指标层保留版本管理能力,保留历史版本而不覆盖,这样历史期间的数据仍可按当时口径复现。这在审计和年度对比时是必需的。
结语
数据接入与多账套合并,是整套方案里最不显眼的两层。
不显眼,是因为它们的成果不体现在页面上——没有驾驶舱的视觉冲击,也没有 AI 问数的新奇感。但正是这两层,决定了老板问"上个月到底赚了多少钱"时,系统能不能在当天给出一个和财务账对得上、而且能一路点到原始单据的答案。
数据接得准,合并合得准,口径才能定得准;口径定得准,答案才有人信;答案有人信,看板和问数才有价值。这个顺序不能颠倒,颠倒的代价是几个月后无法排查的返工。